这是我在 2025 年 7 月阅读张祥雨访谈后的笔记。他是一位长期从事研究的科学家。 这并非传统意义上的同行评议科学论文,在我看来,这更像是一场更加详尽的、Ilya1级别的演讲。 我强烈建议你在一个非常理性的模式/环境中聆听/阅读它,值得你花时间。
Podwise2 已经自动生成了许多亮点和摘要 所以我不会在这里复制粘贴。 不过我会列出从这次演讲中得出的最重要的经验,以及与之相关的我的模糊思考
1. 仅依靠图像扩展性较差
这实际上是比原始演讲更大的断言,原演讲更多的是关于”图像自监督学习扩展性较差”。 首先,根本不存在所谓的无监督学习。 LLM有两种形式的强监督:1. 语言本身结构良好,2. 选择训练哪些数据本身就是一种标注形式。3 张祥雨的洞察是,视觉中的SSL实际上是有监督的,因此受到开发者制作增强技术知识的限制。更具体地说:
- 对比学习本质上是学习人类对颜色/尺度/长宽比等对象不变性的理解。
- 掩码自编码器本质上是学习遮挡不变性
但我们还希望有更多: 物理学、组合、对象关系、因果效应 视频中的SSL可能有机会解决这个问题,但时间冗余让我怀疑暴力扩展是否高效。VideoMAE 用很高的掩码比例利用这种冗余4;这并不能证明视频学习存在普遍的上限。更高效的解决方案还有待出现。
现在谈谈我个人对”监督学习同样扩展性较差”这一说法的看法。 Google DeepMind5、Meta6 和 BAAI7 的大型视觉编码器研究确实报告了基准表现的提升。这些研究涉及规模与训练配方的改进,不能一概视为只改变模型规模的对照实验。尽管如此,在我看来,其中一些提升对实际应用仍可能只是锦上添花。 我怀疑它能否将许多应用从不好|好|优秀的使用层级中提升。 我甚至相信图像分辨率(因此利用的token数量)在图像理解中起着更大的作用,至少它确实在整体理解vs定位/OCR权衡中产生了显著差异8
2. LLM逆向扩展现象
我把逆向扩展研究910与关于“涌现能力”的讨论11联系在一起。按照我对访谈的理解,祥雨提出的直观解释是:更大的模型可能对任务有更强的直觉,却也更倾向于跳步直接回答,而不是一步步求解。所引论文中的 CoT 提示实验能够改善某些扩展曲线,但这并不证明所有推理任务都遵循同一种机制。
这让我想知道视觉是否可以完全通过数据+计算来解决?毕竟,原生视觉模型在你可以通过COT用更多计算进行推理时,并没有动态的”推理电路”。注意:我记得有一个通过自回归图像预测进行推理的例子,但尚未找回对应来源。因此这里保留为一个问题,不把它作为这项判断的证据。
3. 推理模型的力量
这是演讲中最迷人的部分。这已经不是秘密了
我对祥雨假设的理解是:许多推理模式已存在于预训练中,后训练帮助引出这些模式。我不把它理解为后训练绝不可能引入新知识的证明。在这种解释下,RL 更善于从预训练中引出现有模式(如 CoT),顿悟时刻的词语(等等…)是高质量数学讨论数据中的常见短语。当与测试时计算结合时,允许模型在”思考路径”上动态利用更多token,具有更高的成功率,并且还能适应之前错误选择的路径。
我的直觉是:
- 与其在具有多模态性质和不可约方差的token上猛击,我们更希望监督思考电路
- RL是比SFT更好的搜索然后引出现有模式的方法
- 用外行的话来说,RL在 模型的观点 中探索更好的解决方案,并帮助模型在解决方案空间而不是token空间中发展 更好的”直觉”
更新:后来我找到一段讨论 RL 为何值得期待的课程14,很有启发。
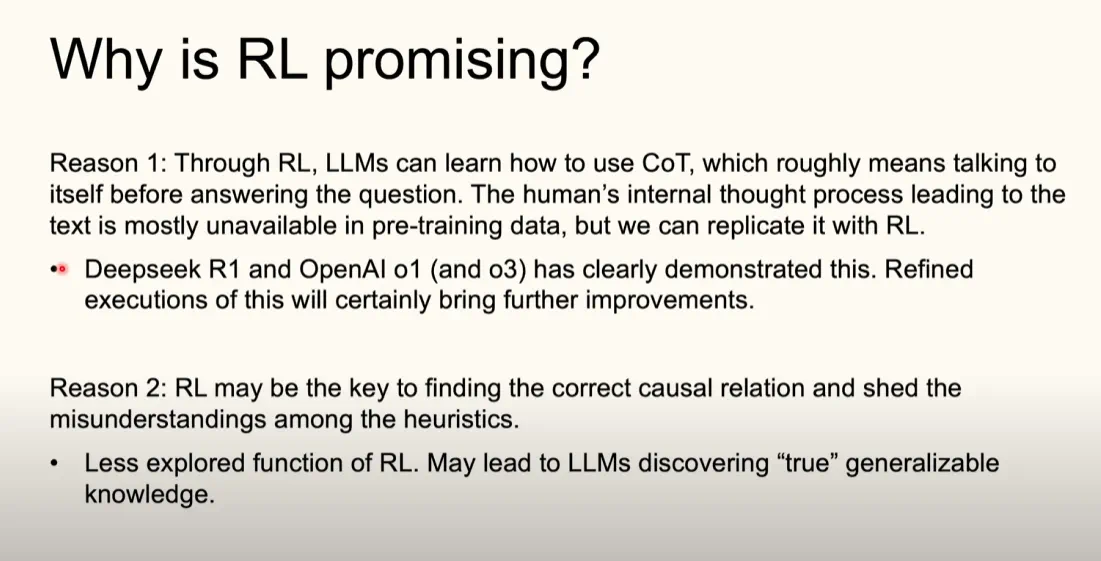
Ernest K. Ryu 的课程幻灯片,第 30 页。它提出了对 RL 的两点期待;其中“发现可泛化的知识”仍以可能性表述,并非已证实的普遍结论。14
4. 图像推理的路径
OpenAI O3是15图像推理可能性的活生生的证明。 如果你还没有看过,一定要看看;真正特别,甚至神奇。
需要明确的是,这些是我在 2025 年 7 月的理解;我当时并不了解 o3 的具体训练与实现细节。
祥雨的洞察是,这很可能也可以追溯到预训练
- 有很多关于图像的解释模式
- 这些模式经常涉及标注或简单地缩放到感兴趣的区域,例如修理电子产品、标记工具的特殊用法等。
- O3的思考模式可以看作是裁剪/缩放/标注模式的成功引出
- 顺便说一句,在所链接的示例中,裁剪操作通过 Python 执行;这能展示工具的使用,却不能揭示模型的训练方式。至于接口设计,我仍觉得更结构化、参数化的函数调用更合适
出处与延伸
参考资料
- Ilya Sutskever, Why Next-Token Prediction Could Surpass Human Intelligence(这里用于类比 Ilya 的演讲,不是张祥雨的访谈): https://www.youtube.com/watch?v=Yf1o0TQzry8 ↩
- Podwise: 张小珺商业访谈录,第 102 期 ↩
- 未核实的回忆:尚未确认原始演讲及讲者,因此这里不作为已确认的引述。 ↩
- VideoMAE: Masked Autoencoders are Data-Efficient Learners for Self-Supervised Video Pre-Training: arXiv:2203.12602v1 ↩
- SigLIP 2: Multilingual Vision-Language Encoders with Improved Semantic Understanding, Localization, and Dense Features: arXiv:2502.14786v1 ↩
- Perception Encoder: The best visual embeddings are not at the output of the network: arXiv:2504.13181v1 ↩
- EVA-CLIP-18B: Scaling CLIP to 18 Billion Parameters: arXiv:2402.04252v1 ↩
- 有关分辨率与表征取舍的相关证据:Perception Encoder, arXiv:2504.13181v1。该研究并未证明分辨率普遍比模型规模更重要。 ↩
- Inverse Scaling: When Bigger Isn’t Better: arXiv:2306.09479v1 ↩
- 逆向扩展可能变成U型:arXiv:2211.02011v1 ↩
- https://www.jasonwei.net/blog/common-arguments-regarding-emergent-abilities ↩
- SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training: arXiv:2501.17161v1。结论针对实验中的规则与视觉变体,不是关于 SFT 的普遍定律。 ↩
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning: arXiv:2501.12948v1 ↩
- Ernest K. Ryu,Reinforcement Learning of Large Language Models(Spring 2025),Chapter 0。课程页、原始幻灯片,第 30 页、视频。 ↩ ↩2
- https://simonwillison.net/2025/Apr/26/o3-photo-locations/ ↩