相信我,我确实相信 scaling law——也就是数据加算力便足够的那套范式。
“更少的结构,更多的智能”1,这个想法很吸引我。
但是,我们还没走到那一步,至少医学影像领域还没有。
所以,我们还是得利用先验知识(也就是领域知识),来提高训练效率和数据利用率。
在深入医学影像的具体例子之前,我想先指出:
许多自然图像的计算机视觉任务也在利用先验知识
- 在我看来,姿态关键点检测依赖的是 人为定义的骨架结构解读 ,而不是自然学习得到的表示。
- BEV 特征聚合由人工计算的极线一致性预先定义。
- 说到自动驾驶,这篇在 Transformer 位置编码中对坐标系进行建模的目标轨迹预测论文,就很有意思2。
放射科医生利用先验知识构建更好的可视化
-
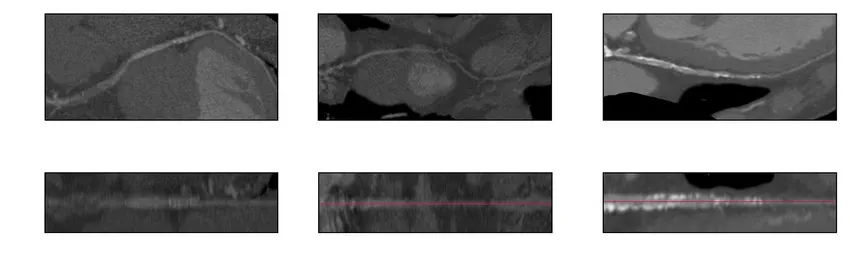
曲面多平面重建(CPR)和拉直多平面重建(sMPR)常用于诊断冠状动脉疾病。这些技术本质上是沿着一个平面,把三维血管展开成一条直线,去掉海量三维体素中的其他信息,让血管的结构和内部情况更容易解读。
-
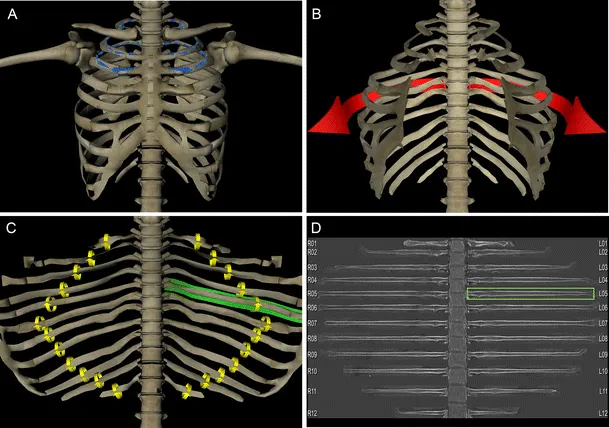
类似地,肋骨展开可视化能让人更容易、更快地定位肋骨骨折,即使不是专家也一样。
医学图像分析中的例子
还有很多——这里只列举几个我这些年遇到的例子
-
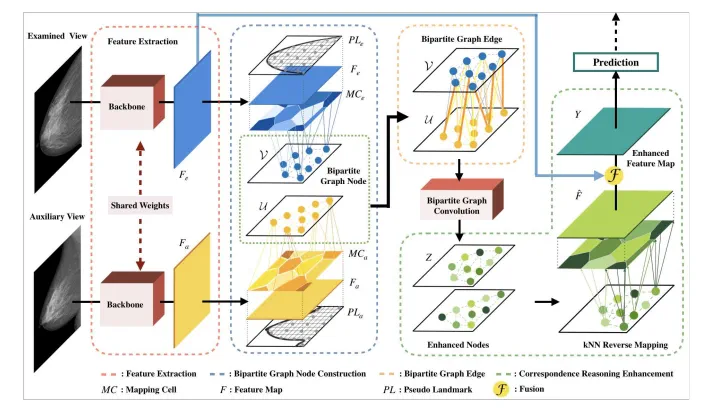
乳腺 X 线摄影中的肿块检测:肿块特征应当在多个视图之间相互关联
-
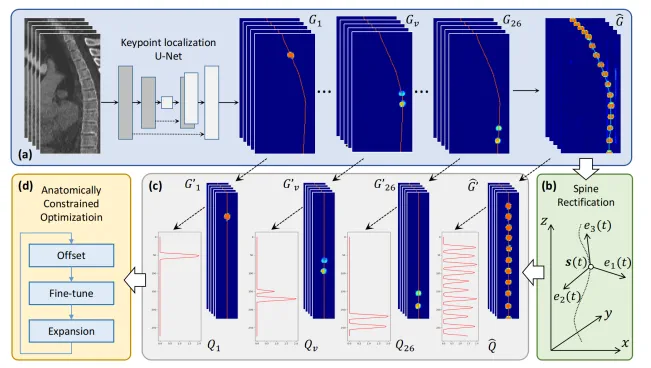
CT 中的椎骨定位与识别:各节椎骨应当沿脊柱形成一条连贯的中心线
-
可疑淋巴结的恶性预测:应当考虑周围淋巴结的情况
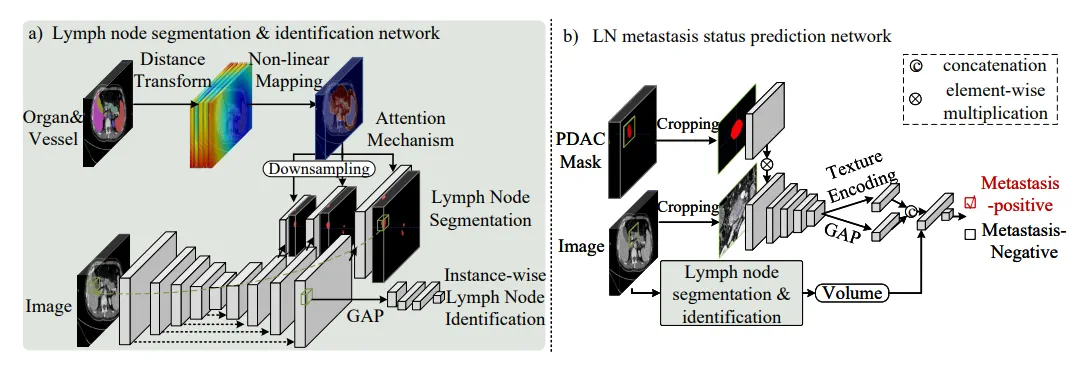
-
血管中心线提取:用图(节点)来建模,比用分割(体素)更容易、效果也更好
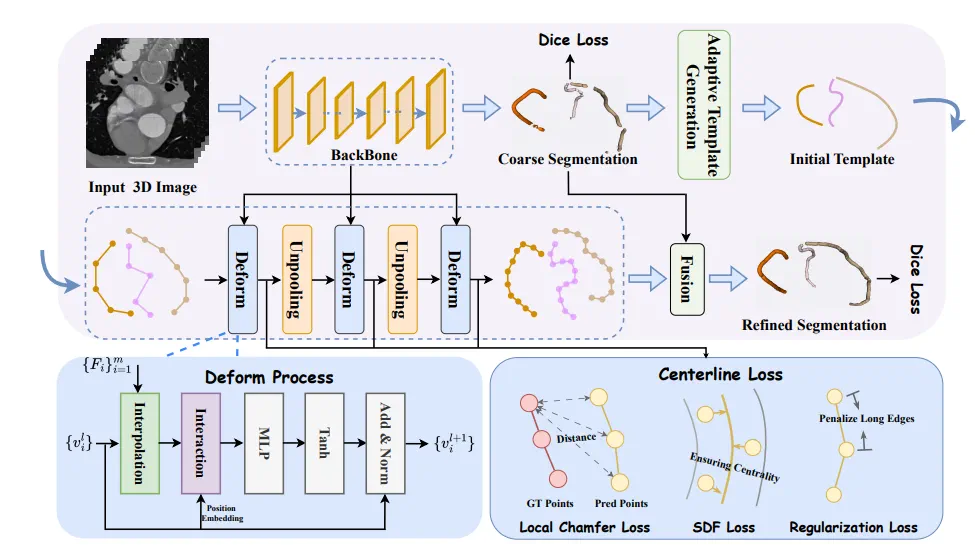
更不用说,算法也会建立在那些为方便人类解读而设计的专门重建结果之上。放射科医生更容易辨认的东西,模型也更容易学会,这并不让人意外。
利用先验知识,到底是在做什么?
本质上,利用先验知识,就是以“张量亲和关系”的形式,把有生物学、物理学或病理学依据的知识带入模型:
- 选择一个抽象层次:像素空间、空间特征空间、语义特征空间、实例特征空间,等等。
- 以启发式的方式设定 “通信规则” (哪些张量应该与哪些张量通信)
- 选择一种通信方式(特征聚合)——默认选项是 Transformer
- 注意,结果可能会 变换到一个全新的空间 ,比如从稠密像素变成稀疏节点,反过来也一样
医学影像中的先验知识
关于人体,我们最应该利用的先验是解剖先验:
- 标志点:关键的解剖参考点
- 相对稳定性:身体各部位之间的位置和形状关系保持相对稳定
- 对称性:许多结构具有左右对称性
- 拓扑结构:这一点我觉得特别有意思,但研究还不够充分。大多数方法假设的拓扑过于简单,再用贝蒂数等数学工具来建模
第二重要的先验是人体的生物系统:
- 影响某个生物系统的疾病,往往会同时影响该系统的多个部分
出处与延伸